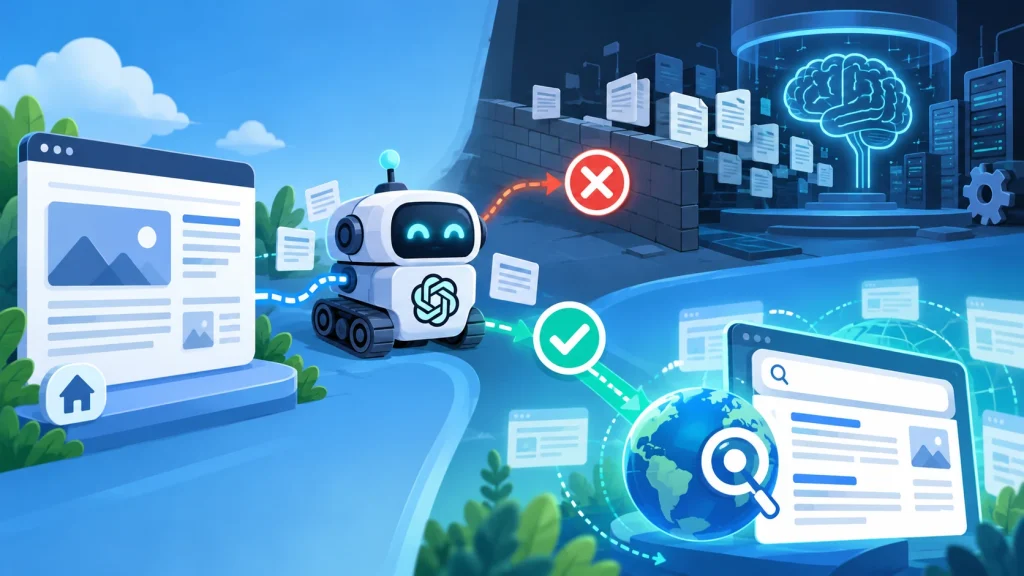
GPTBot 是 OpenAI 用來抓取可能用於訓練生成式 AI 基礎模型之網站內容的機器人。它不是 ChatGPT 搜尋機器人,也不是「ChatGPT 推薦開關」。網站可以不允許 GPTBot,同時仍允許 OAI-SearchBot 讓公開內容具備出現在 ChatGPT 搜尋中的條件。
GPTBot 是什麼?
GPTBot 是 OpenAI 的網站機器人之一。
OpenAI 目前說明,GPTBot 會抓取可能被用來改善與訓練生成式 AI 基礎模型的網站內容。
因此它主要處理的是「網站內容是否可用於潛在模型訓練用途」這個問題。
GPTBot 是 ChatGPT 搜尋機器人嗎?
不是。
ChatGPT 搜尋主要使用的是 OAI-SearchBot。
GPTBot 與 OAI-SearchBot 是不同用途的控制,企業不應把兩者混為一談。
GPTBot 和 OAI-SearchBot 有什麼差別?
| 名稱 | 主要用途 |
|---|---|
| GPTBot | 抓取可能用於訓練 OpenAI 生成式 AI 基礎模型的內容 |
| OAI-SearchBot | 讓網站內容具備出現在 ChatGPT 搜尋結果中的搜尋發現條件 |
簡單來說,一個偏向模型訓練用途,一個偏向搜尋用途。
阻擋 GPTBot,ChatGPT 搜尋還找得到網站嗎?
可以把這兩件事分開控制。
OpenAI 目前明確表示,網站可以允許 OAI-SearchBot,以具備出現在 ChatGPT 搜尋中的條件,同時阻擋 GPTBot,表示網站內容不應被用於生成式 AI 基礎模型訓練。
因此阻擋 GPTBot 本身,不等於退出 ChatGPT 搜尋。
想被 ChatGPT 搜尋找到,一定要允許 GPTBot 嗎?
不需要。
搜尋與模型訓練是兩個不同用途。
企業如果希望公開網站可以被 ChatGPT 搜尋發現,真正需要另外關注的是 OAI-SearchBot 的搜尋存取條件,而不是把 GPTBot 當成搜尋必要條件。
允許 GPTBot,會讓網站比較容易被 ChatGPT 推薦嗎?
不能這樣推論。
GPTBot 的角色是模型訓練相關內容抓取,不是 ChatGPT 搜尋排名訊號。
因此允許 GPTBot 不能保證:
- ChatGPT 一定推薦企業。
- 網站一定被引用。
- ChatGPT 搜尋排名提高。
- 品牌在更多問題中出現。
阻擋 GPTBot,也不代表 ChatGPT 會處罰網站
企業如果選擇不讓 GPTBot 使用網站內容進行潛在模型訓練,不應把這個決策理解成「搜尋處罰」。
OpenAI 已將搜尋與 GPTBot 控制分開,ChatGPT 搜尋應另外看 OAI-SearchBot。
所以企業可以「要搜尋曝光,但不要模型訓練」嗎?
可以。
這正是 OpenAI 將不同機器人分開控制的重要原因。
希望網站能被 ChatGPT 搜尋找到,和是否同意網站內容被用於生成式 AI 基礎模型訓練,是兩個可以分開做決策的問題。
企業為什麼會考慮是否允許 GPTBot?
這比較接近企業的內容治理與使用政策,而不是 SEO 排名問題。
不同企業可能會考量:
- 公開內容是否願意被用於潛在模型訓練。
- 內容是否涉及授權或著作權限制。
- 是否有付費內容或特殊資料。
- 公司的 AI 內容使用政策。
- 公開資訊與受保護資訊之間如何區分。
GPTBot 問題本質上不是「做不做 GEO」
GEO 關心的是企業在生成式 AI 搜尋環境中的可發現與可理解性。
GPTBot 則主要涉及內容是否可以被用於潛在模型訓練。
兩者都和 AI 有關,但不是同一層問題。
做 GEO 不代表一定要允許 GPTBot
企業不能因為希望增加 ChatGPT 搜尋能見度,就誤以為必須同時允許 GPTBot。
OpenAI 已經提供獨立的搜尋控制,因此搜尋可發現性與模型訓練政策可以分開管理。
GPTBot 也不是決定內容會不會即時出現在回答中的機器人
另一個常見誤解,是認為 GPTBot 今天抓了某個頁面,ChatGPT 明天就一定會知道或引用該內容。
這不能直接成立。
模型訓練用途與 ChatGPT 搜尋使用即時網路資訊,是不同機制。
那 ChatGPT-User 又和 GPTBot 有什麼不同?
ChatGPT-User 主要用於某些由使用者主動觸發的網站存取。
例如使用者要求 ChatGPT 存取某個網頁時,可能出現這類請求。
它不是用來自動抓取整個網路,也不是 GPTBot 的模型訓練控制。
三個 OpenAI 網站機器人/使用者代理可以這樣理解
| 項目 | 主要用途 |
|---|---|
| OAI-SearchBot | ChatGPT 搜尋中的網站發現 |
| GPTBot | 生成式 AI 基礎模型訓練相關內容抓取 |
| ChatGPT-User | 部分由使用者主動觸發的網站存取 |
不要把 GPTBot 當成 SEO 或 GEO 排名技巧
網站允許或阻擋 GPTBot,主要是內容使用政策的選擇。
它不應該被包裝成:
- ChatGPT 排名技巧。
- AI 推薦加分設定。
- GEO 必開功能。
- 提高引用率的秘密方法。
企業真正需要決定的是「內容能不能被拿去做什麼」
企業主真正需要做的是政策判斷,而不是背機器人名稱。
可以分成兩個問題:
- 我們希望公開網站被 ChatGPT 搜尋找到嗎?
- 我們是否願意讓網站內容被用於潛在的生成式 AI 基礎模型訓練?
把這兩個問題分開,才不會因為害怕模型訓練而誤傷搜尋曝光,或為了搜尋曝光而接受原本不想接受的內容用途。
企業主不需要自己研究 robots.txt 與網站機器人設定
真正涉及網站設定時,可能還會牽涉主機、防護系統與網站層級的技術條件。
企業主應該先決定內容政策,再由專業人員處理適合的技術設定與驗證。
MycelBlock 為什麼把 GPTBot 和搜尋能見度分開處理?
因為這兩者解決不同問題。
| 企業問題 | 主要方向 |
|---|---|
| ChatGPT 搜尋能不能發現網站 | 搜尋存取與 OAI-SearchBot |
| 網站內容是否清楚、容易被理解 | SEO/AEO/GEO 與公開資訊 |
| 內容是否允許用於潛在模型訓練 | GPTBot 與內容治理政策 |
不要因為阻擋 GPTBot,就誤以為 GEO 已經不能做
GEO 並不等於讓所有 AI 機器人無條件使用網站內容。
企業仍然可以依自己的內容政策管理模型訓練用途,同時改善網站的搜尋可發現性、資訊清楚度與生成式 AI 搜尋能見度。
也不要因為允許 GPTBot,就認為 GEO 已經完成
即使允許 GPTBot,也沒有解決:
- 網站是否容易被搜尋。
- 企業服務是否清楚。
- 內容是否回答真實需求。
- 公開資訊是否一致。
- 搜尋曝光是否真的改善。
因此 GPTBot 只是內容治理的一個邊界,不是完整的 GEO 工作。
常見問題
GPTBot 是拿來做 ChatGPT 搜尋的嗎?
不是。ChatGPT 搜尋主要由 OAI-SearchBot 管理網站搜尋發現;GPTBot 主要和生成式 AI 基礎模型訓練用途有關。
阻擋 GPTBot,ChatGPT 還能搜尋我的網站嗎?
搜尋與 GPTBot 可以分開控制。如果網站允許 OAI-SearchBot,阻擋 GPTBot 本身不等於退出 ChatGPT 搜尋。
允許 GPTBot 可以提高 ChatGPT 排名嗎?
沒有這種保證。GPTBot 不是 ChatGPT 搜尋排名或推薦控制。
做 GEO 一定要允許 GPTBot 嗎?
不需要把兩者綁在一起。企業可以依內容政策管理模型訓練用途,同時處理 ChatGPT 搜尋與其他 GEO 問題。
企業應該允許還是阻擋 GPTBot?
沒有所有企業都適用的單一答案。這取決於企業對公開內容、著作權、授權、模型訓練與內容治理的政策,不應只用 SEO 排名角度決定。
GPTBot 管的是模型訓練邊界,不是 ChatGPT 搜尋排名
理解 GPTBot 最重要的地方,就是把「模型訓練」和「搜尋發現」分開。
企業可以希望被 ChatGPT 搜尋找到,同時保留對網站內容是否參與模型訓練的選擇權。
這也是 MycelBlock 在 SEO/GEO 搜尋成長與網站內容治理上需要替企業分開判讀的兩個問題。